
Chapitre 4 — La structure des protéines · Topic 3 : Structures secondaires, tertiaire et quaternaire · Leçon 3.2
Les hélices et les feuillets ne flottent pas isolément : ils s’assemblent en motifs récurrents, qui se combinent eux-mêmes en domaines. Et comme ces assemblages dépendent des propriétés des acides aminés, on peut aujourd’hui prédire la structure d’une protéine à partir de sa seule séquence. Cette leçon présente ces deux idées : motifs/domaines, et prédiction bioinformatique.
🎯 Objectifs pédagogiques
À la fin de cette leçon, tu sauras :
- définir un motif et un domaine ;
- citer le motif hélice-coude-hélice et le domaine immunoglobulinique ;
- expliquer le principe de la prédiction bioinformatique ;
- interpréter une valeur de propension (= 1, >> 1, << 1).
🧭 Plan de la leçon
- Motifs et domaines : des assemblages de structures secondaires
- Deux exemples à connaître
- La prédiction bioinformatique de structure
1. Motifs et domaines : des assemblages de structures secondaires
Les motifs et les domaines correspondent à des combinaisons de structures secondaires (hélices α, feuillets β, coudes). Leur caractéristique remarquable : ils peuvent se retrouver dans des protéines différentes, tout en apportant une fonction commune.
Autrement dit, reconnaître un motif ou un domaine dans une protéine donne souvent un indice fort sur sa fonction — même si les deux protéines n’ont par ailleurs rien à voir.
Motif / domaine = combinaison de structures secondaires. On peut les retrouver dans des protéines différentes, où ils apportent une fonction commune.
2. Deux exemples à connaître
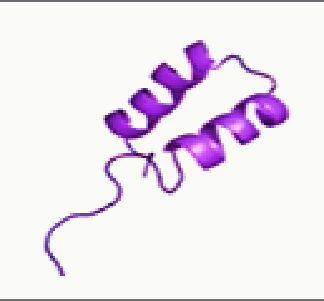
Le motif hélice-coude-hélice est composé de deux hélices α séparées par un coude. On le retrouve fréquemment dans les protéines se fixant à l’ADN (facteurs de transcription, par exemple).
Le domaine immunoglobulinique est l’élément constitutif des immunoglobulines (anticorps). C’est une structure globulaire compacte, très riche en feuillets β.
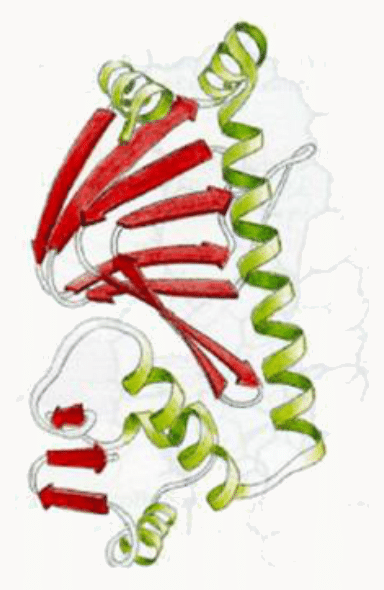
Hélice-coude-hélice → hélices α → fixation à l’ADN. Domaine immunoglobulinique → feuillets β → anticorps. C’est le type d’association « structure ↔ fonction » que le concours adore vérifier.
3. La prédiction bioinformatique de structure
Puisque chaque acide aminé, par les propriétés de sa chaîne latérale, privilégie certains environnements conformationnels, on peut tenter de prédire la conformation tridimensionnelle d’une protéine à partir de sa seule structure primaire (sa séquence).
Les analyses bioinformatiques évaluent la probabilité de trouver un acide aminé donné dans une structure secondaire donnée (sa « propension »), puis proposent un modèle de conformation. On interprète cette valeur ainsi :
| Valeur de propension | Interprétation |
|---|---|
| ≈ 1 | L’acide aminé n’est pas plus fréquent dans cette structure que dans les autres |
| >> 1 | L’acide aminé est fréquemment rencontré dans la structure analysée |
| << 1 | L’acide aminé est très rarement rencontré dans cette structure |
La prédiction de structure a connu une révolution récente. En 2020, Demis Hassabis et John Jumper (DeepMind) présentent AlphaFold2, un modèle d’intelligence artificielle qui prédit la structure 3D des protéines avec une précision inédite. Avec David Baker (conception de protéines), ils reçoivent le prix Nobel de chimie 2024. AlphaFold a depuis prédit la structure de presque toutes les protéines connues.
On peut prédire la conformation 3D à partir de la structure primaire, car chaque acide aminé privilégie certains environnements. Propension ≈ 1 (banal), >> 1 (fréquent), << 1 (rare) dans la structure analysée.
🧠 À retenir absolument
- Motif / domaine = combinaison de structures secondaires, retrouvable dans des protéines différentes avec une fonction commune.
- Motif hélice-coude-hélice : 2 hélices α + 1 coude ⇒ fréquent dans les protéines fixant l’ADN.
- Domaine immunoglobulinique : globulaire compact, riche en feuillets β ⇒ constitutif des anticorps.
- La prédiction bioinformatique part de la structure primaire pour proposer la conformation 3D.
- Propension : ≈ 1 = banal, >> 1 = fréquent, << 1 = rare dans la structure analysée.
❓ Questions fréquentes
Quelle différence entre un motif et une structure secondaire ?
Une structure secondaire est un élément local unique (une hélice α, un feuillet β…). Un motif (et, plus largement, un domaine) est une combinaison de plusieurs structures secondaires. Motifs et domaines peuvent se retrouver dans des protéines différentes en y apportant une même fonction.
Qu’est-ce que le motif hélice-coude-hélice ?
C’est un motif formé de deux hélices α séparées par un coude. On le rencontre fréquemment dans les protéines qui se fixent à l’ADN, comme certains facteurs de transcription.
Qu’est-ce que le domaine immunoglobulinique ?
C’est l’élément constitutif des immunoglobulines (les anticorps). Il s’agit d’une structure globulaire compacte, très riche en feuillets β.
Sur quoi repose la prédiction bioinformatique de structure ?
Sur le fait que chaque acide aminé, selon les propriétés de sa chaîne latérale, privilégie certains environnements conformationnels. En analysant la probabilité de trouver tel acide aminé dans telle structure secondaire, on peut proposer un modèle de conformation tridimensionnelle à partir de la seule séquence (structure primaire).
Comment interpréter une valeur de propension ?
Une valeur proche de 1 signifie que l’acide aminé n’est pas plus fréquent dans la structure analysée que dans les autres. Une valeur très supérieure à 1 indique qu’il y est fréquemment rencontré ; une valeur très inférieure à 1 qu’il y est très rare.
🚀 Pour aller plus loin
Motifs et domaines mènent naturellement à la vue d’ensemble : les niveaux de structure.
Contenu pédagogique original — Réussir SVT. L’équipe Réussir SVT.