
Chapitre 3 — Données de santé · Topic 1 · Leçon 1.2
Quand un chercheur veut travailler sur des données patients, quand une base d’essai clinique circule entre laboratoires, quand une agence publie des statistiques d’incidence — chaque fois, la question se pose : peut-on encore remonter à la personne ? Le RGPD répond avec trois notions à ne surtout pas confondre : la pseudonymisation (dé-identification réversible), l’anonymisation (dé-identification irréversible) et les données agrégées.
🎯 Objectifs pédagogiques
- Définir la pseudonymisation au sens de l’art. 4 du RGPD ;
- Définir l’anonymisation et comprendre pourquoi elle sort du champ du RGPD ;
- Nommer les 3 critères du groupe de l’article 29 (individualisation, corrélation, inférence) ;
- Comprendre la place particulière des données agrégées ;
- Savoir pourquoi « une donnée pseudonymisée n’est pas une donnée anonyme ».
🧭 Plan de la leçon
- Le paysage des données selon leur caractère identifiant
- La pseudonymisation — un traitement réversible
- L’anonymisation — un traitement irréversible
- Les données agrégées
- Trois points-clés qui tombent au concours
1. Le paysage des données selon leur caractère identifiant
Avant de disséquer chaque technique, une vue d’ensemble. Les données personnelles se déclinent en cercles emboîtés : directement identifiantes, indirectement identifiantes (dont les pseudonymisées) ; à part, hors du champ des données personnelles, se trouvent les données véritablement anonymes.
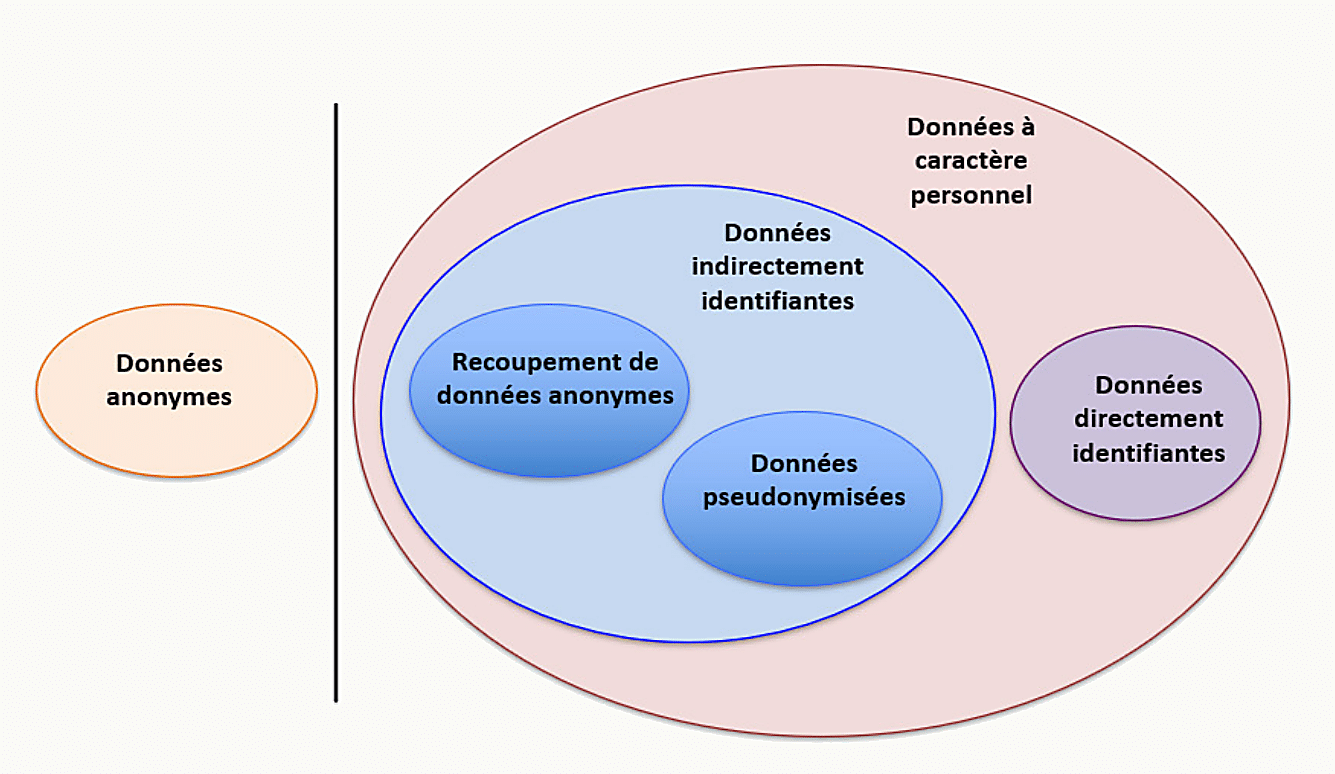
La ligne rouge se situe entre données à caractère personnel (tous les cercles à droite dans la figure — soumises au RGPD) et données anonymes (à gauche — hors du champ du RGPD). Une donnée pseudonymisée reste dans le champ RGPD : c’est un point d’examen classique.
2. La pseudonymisation — un traitement réversible
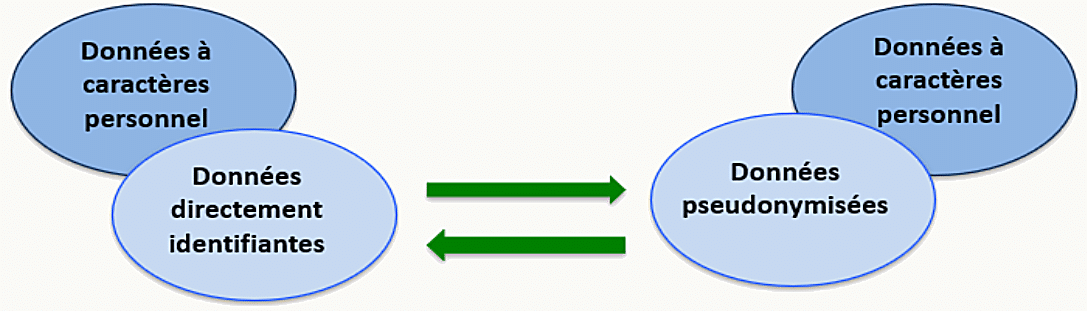
La pseudonymisation est le « traitement de données à caractère personnel de telle façon que celles-ci ne puissent plus être attribuées à une personne concernée précise sans avoir recours à des informations supplémentaires, pour autant que ces informations supplémentaires soient conservées séparément et soumises à des mesures techniques et organisationnelles afin de garantir que les données à caractère personnel ne sont pas attribuées à une personne physique identifiée ou identifiable ».
- Constitue une des mesures recommandées par le RGPD pour limiter les risques ;
- Très utilisée en recherche en santé ;
- Est un traitement réversible ;
- Consiste à remplacer les données directement identifiantes (nom, prénom…) par des données indirectement identifiantes (alias, numéro séquentiel…) ;
- Permet le chaînage et l’appariement des données d’un même individu.
Un essai clinique multicentrique doit partager des données entre trois hôpitaux et l’institut promoteur. Chaque patient est encodé sous la forme Patient-XXX-Ville, où XXX = 3 premières lettres du prénom et Ville = ville d’inclusion. La table de correspondance (Patient-CLA-Paris ↔ Claire Martin, née le 12/03/1978) est stockée séparément, chez le promoteur, sur un serveur chiffré, avec journalisation des accès. La donnée pseudonymisée reste donc à caractère personnel — et le RGPD s’applique.
3. L’anonymisation — un traitement irréversible
L’anonymisation utilise « un ensemble de techniques de manière à rendre impossible, en pratique, toute identification de la personne par quelque moyen que ce soit et de manière irréversible ». C’est un processus à sens unique : il n’existe plus de chemin praticable pour remonter à la personne.
- La législation sur la protection des données ne s’y applique plus — ce n’est plus une donnée à caractère personnel ;
- On peut exploiter ces données sans les contraintes légales et sans porter préjudice au patient (il n’est pas ré-identifiable) ;
- Elle ouvre des potentiels de ré-utilisation initialement interdits ;
- Elle permet de conserver les données sans limite de temps (les données personnelles ont des délais de conservation ; les anonymes non).
Le « groupe de travail — Article 29 — sur la protection des données » (G29, qui regroupait les autorités européennes de protection des données avant d’être remplacé par le CEPD en 2018) a publié en 2014 un avis proposant 3 critères d’évaluation d’une solution d’anonymisation :
- Individualisation : est-il toujours possible d’isoler un individu dans le jeu de données ?
- Corrélation : est-il possible de relier entre eux des ensembles de données distincts concernant un même individu ?
- Inférence : peut-on déduire, avec une probabilité significative, une information sur un individu ?
Une solution vraiment anonymisante doit répondre NON aux trois critères. Si une seule des réponses est « oui », la donnée n’est pas anonyme — elle est, au mieux, pseudonymisée.
En 2006, Netflix publie un jeu de données « anonymisé » de 100 millions de notes d’utilisateurs pour un concours d’algorithmes de recommandation. Deux chercheurs de l’université du Texas montrent en 2008 qu’en croisant ces notes avec la base IMDb (publique), on peut ré-identifier une part significative des utilisateurs — et donc, dans certains cas, en déduire leur orientation politique ou sexuelle. Ce cas a marqué durablement les esprits : une « anonymisation » qui ne résiste pas au croisement avec une autre base n’est pas une anonymisation. C’est exactement le critère 2 (corrélation) du G29.
4. Les données agrégées
Les données agrégées sont de nouvelles données calculées à partir d’un jeu source, généralement de nature statistique : moyennes, médianes, quartiles, écart-type, effectifs par classe d’âge…
Elles ne comportent généralement pas de données à caractère personnel — mais il peut y avoir des exceptions : cas des âges ou valeurs métriques extrêmes, qui peuvent isoler un individu unique dans une classe.
Statistique = anonyme, en général. Mais imaginez un tableau « taille moyenne des internes en 4e année de neurochirurgie au CHU X en 2025 » avec un effectif de 2 femmes et 8 hommes : la valeur « femmes = 178 cm » pointe potentiellement une personne identifiable. Les organismes producteurs (Insee, DREES) appliquent une règle dite du secret statistique : en dessous d’un seuil (souvent 5 à 11 unités), les valeurs sont supprimées ou floutées.
5. Trois points-clés qui tombent au concours
🧠 À retenir absolument
- Pseudonymisation = réversible. Une table de correspondance existe, stockée séparément. La donnée reste à caractère personnel → RGPD s’applique.
- Anonymisation = irréversible. La législation sur la protection des données ne s’y applique plus. Conservation possible sans limite de temps.
- Une donnée pseudonymisée n’est PAS une donnée anonyme. Point cardinal du RGPD.
- Une donnée non directement identifiante peut être une donnée à caractère personnel.
- Les 3 critères du G29 : individualisation, corrélation, inférence. Une solution est anonymisante ssi elle répond non aux trois.
- Données agrégées : généralement pas personnelles, sauf effectifs extrêmes.
❓ Questions fréquentes
Peut-on vraiment anonymiser des données de santé ?
C’est plus difficile qu’il n’y paraît. Plus les données sont riches (génome, imagerie, trajectoire clinique), plus la ré-identification par croisement devient plausible. La CNIL et le CEPD (successeur du G29) considèrent qu’aucune technique unique ne garantit une anonymisation parfaite : il faut combiner suppression, généralisation, permutation, bruit statistique, et vérifier a posteriori les 3 critères. Pour les données de santé fines (génome, imagerie), on parle souvent en pratique de pseudonymisation renforcée plutôt que d’anonymisation véritable.
Le chiffrement est-il une forme d’anonymisation ?
Non. Le chiffrement est une mesure de sécurité : il protège les données contre l’accès non autorisé, mais il reste réversible par toute personne possédant la clé. En termes RGPD, le chiffrement est proche d’une pseudonymisation (avec la clé jouant le rôle de la table de correspondance). Les données chiffrées restent des données à caractère personnel, soumises au RGPD.
Pourquoi remplacer un nom par un numéro séquentiel plutôt que par un pseudonyme aléatoire ?
Un numéro séquentiel (1, 2, 3…) ne porte aucune information sur la personne — c’est le degré maximal de neutralité. Un pseudonyme construit à partir des initiales et de la ville (comme dans l’exemple du cours : Patient-CLA-Paris) est plus lisible pour les chercheurs, mais moins protecteur : quelqu’un connaissant l’essai peut deviner « CLA » = Claire. Le choix dépend du contexte : chaînage de dossiers → séquentiel ; suivi opérationnel dans un centre → alias plus lisible avec table de correspondance stricte.
Le RGPD interdit-il les données pseudonymisées ?
Au contraire : le RGPD recommande la pseudonymisation comme mesure de réduction du risque (art. 25, protection dès la conception). Les données pseudonymisées restent traitables — sous conditions (base légale, finalité, minimisation, sécurité, information, exercice des droits…). Ce que le RGPD sanctionne, c’est un traitement de données personnelles sans justification et sans mesures adéquates, pas la pseudonymisation en tant que telle.
Combien de temps peut-on conserver une donnée anonyme ?
Sans limite. C’est un des grands intérêts de l’anonymisation : elle affranchit des règles de durée de conservation du RGPD (qui exigent un délai proportionné à la finalité — en pratique, 20 ans après la dernière prise en charge pour un dossier de soins en France). Un jeu de données véritablement anonymes peut être archivé indéfiniment à des fins statistiques, historiques ou de recherche. C’est aussi l’un des ressorts de l’open data en santé (Snds, Open Damir).
🚀 Pour aller plus loin
Contenu pédagogique original — Réussir SVT. L’équipe Réussir SVT.